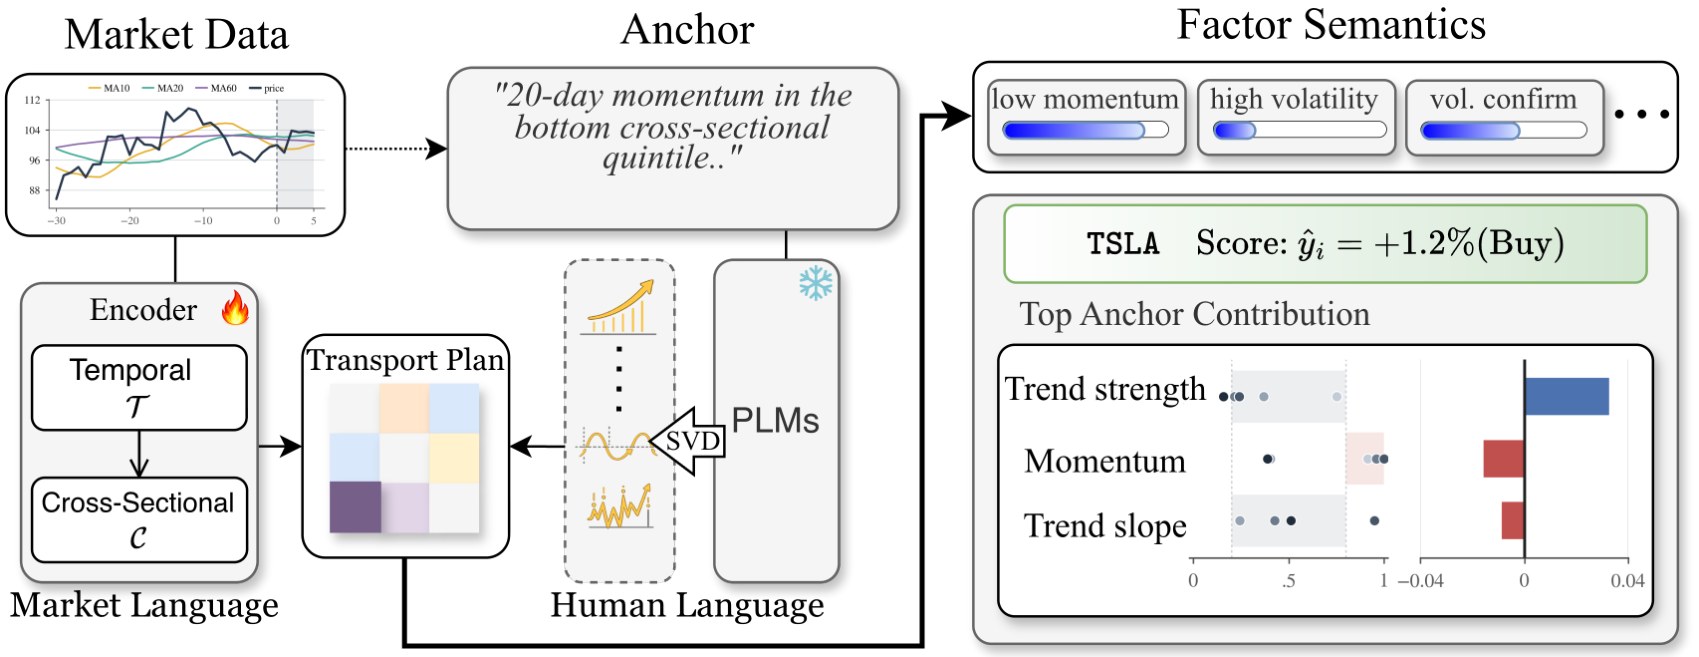
신호에 비해 잡음이 크고 그 신호마저 시간에 따라 바뀌는 데이터에서의 표현학습을 연구하며, 금융 시장을 주된 실증 무대로 삼고 있습니다. 아래 세 갈래는 무엇을 이산화할지, 어떤 구조를 모형에 넣을지, 모형을 어떻게 해석 가능하고 강건하게 만들지를 각각 다룹니다.
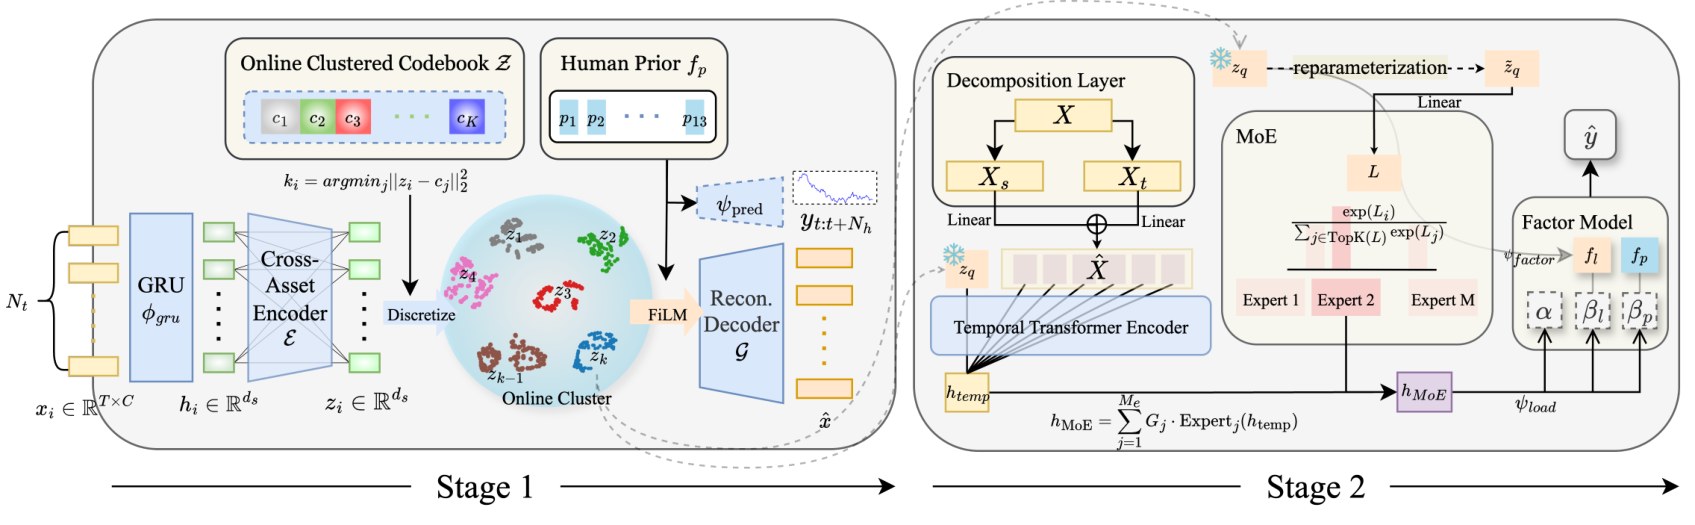
이산 표현학습
벡터 양자화로 잡음이 큰 횡단면 주식 데이터에서 이산 잠재 팩터를 학습하고, 금융 사전지식과 결합해 종목 순위 예측과 포트폴리오 구성에 쓰는 연구. 다음 단계로 시장 상태를 통계적 유사성이 아니라 요구하는 포트폴리오 결정에 따라 이산화하는 방법을 다룸.
논문 및 발표
과제
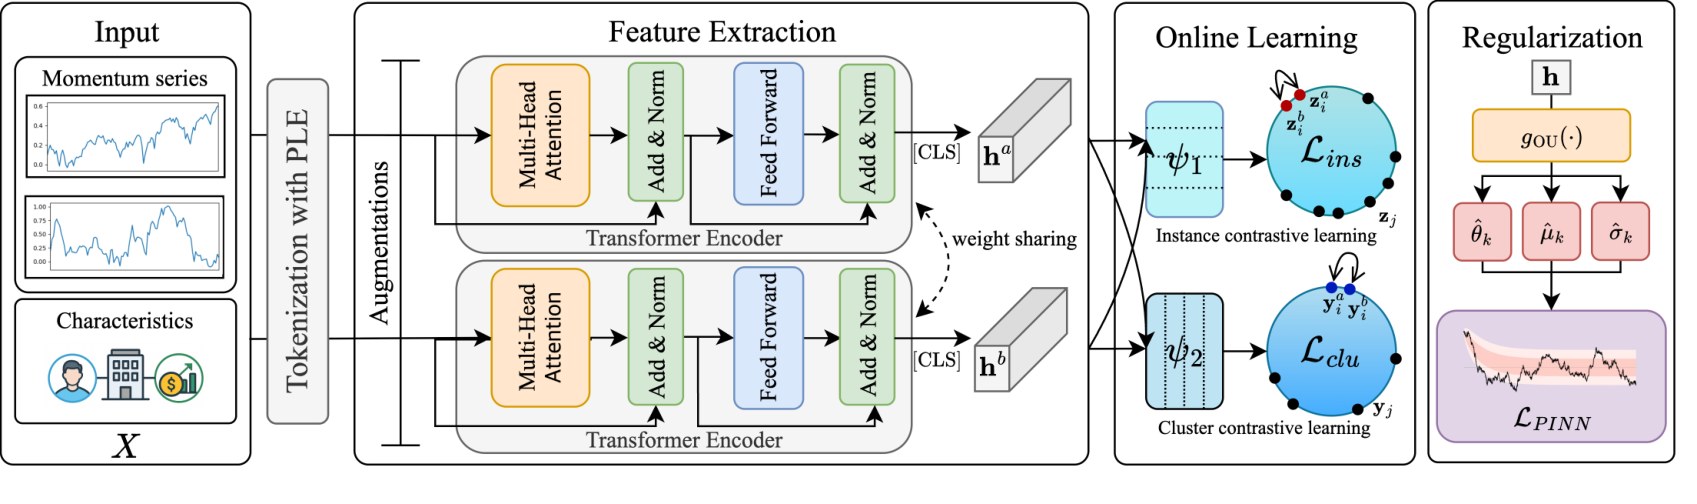
구조 기반 학습
평균회귀, 변동성의 이질적 자기회귀(HAR) 구조, 시계열 분해처럼 금융 시계열에서 알려진 동역학을 신경망에 귀납적 편향으로 넣어, 학습 기간에 없던 국면에서도 성능이 유지되도록 하는 연구.
논문 및 발표
해석 가능하고 집단에 강건한 모형
팩터 모형과 의사결정 정책을 설명 가능하고 집단 간에 강건하게 만드는 연구. 관측 가능한 금융 상태를 자연어 anchor로 표현해 팩터를 구성함으로써 각 팩터를 읽을 수 있고 예측이 이름 붙은 기여도로 정확히 분해되도록 하며, 텍스트로 정의한 종목 집단에 대해 분포적으로 강건한 순위 학습을 하고, 해석 가능한 헤징 정책에 집단 강건성을 결합함.